Мы готовы помочь Вам
Единая память для локальных нейросетей: что умеет Ryzen AI Max+ 395 и когда нужна видеокарта
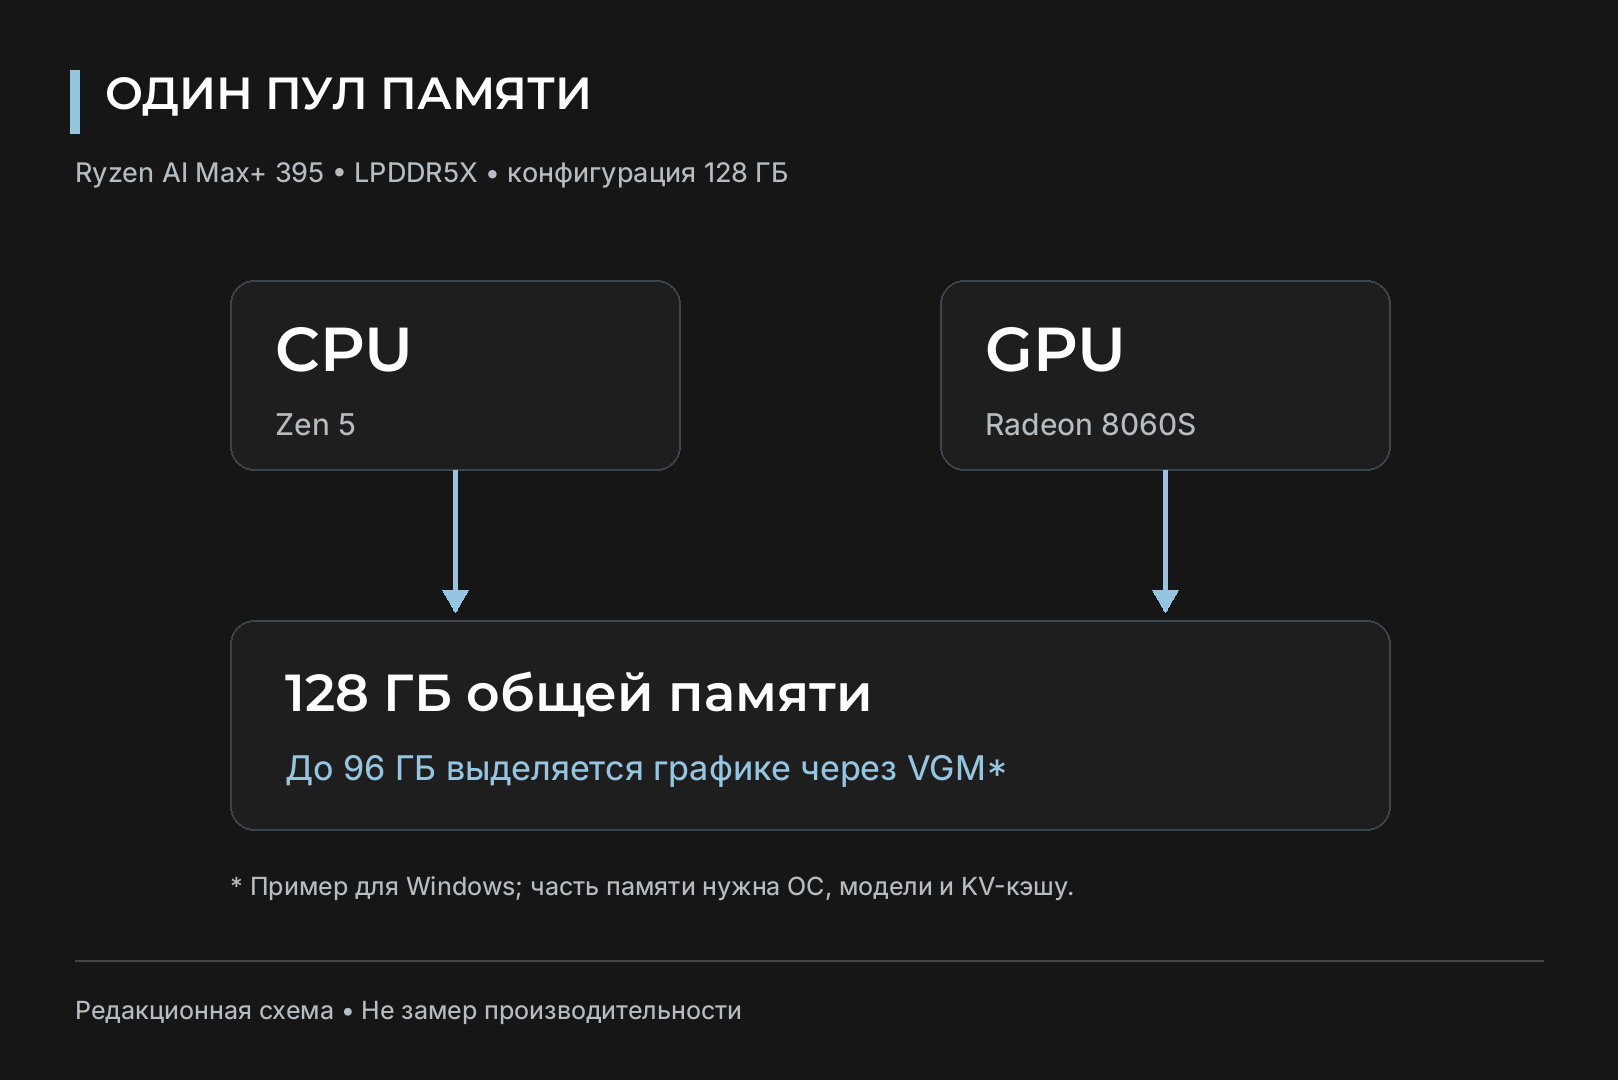
Ryzen AI Max+ 395 (кодовое имя Strix Halo) это процессор AMD, у которого CPU и встроенная графика Radeon 8060S делят до 128 ГБ памяти LPDDR5X-8000. До 96 ГБ можно отдать графике, поэтому на одном чипе помещаются модели масштаба gpt-oss-120b. Плата за это скорость: пропускная способность памяти около 256 ГБ/с, в разы меньше, чем у топовых видеокарт.
Ниже разберём, как устроена такая память, какие модели в неё помещаются, где APU выигрывает у дискретной видеокарты, а где проигрывает, и как выбрать платформу под свои задачи.
Короткий ответ: кому что подходит
| Задача | Что лучше | Почему |
|---|---|---|
| Модели до 30B в 4 битах, быстрые ответы | Дискретная видеокарта | Пропускная способность GDDR7 в разы выше, генерация быстрее |
| MoE-модели 100B+ (gpt-oss-120b, Llama 4 Scout) на одном устройстве | Ryzen AI Max+ 395 со 128 ГБ | Модель целиком помещается в память графики |
| Плотные модели 70B для диалога | Несколько видеокарт или карта с большим объёмом VRAM | На APU скорость генерации остаётся низкой |
| Обучение и дообучение | Дискретные видеокарты NVIDIA | Зрелая экосистема CUDA, высокая вычислительная мощность |
| Компактное рабочее место с ИИ-ассистентом и офисными задачами | Ryzen AI Max+ 395 | Мало места, тихо, всё в одном корпусе |
Что такое единая память и чем она отличается от VRAM
В обычном ПК у видеокарты своя память (VRAM), а у процессора своя (оперативная). Нейросеть быстро работает только тогда, когда все её веса лежат в VRAM. Если модель не помещается, часть слоёв уходит в оперативную память, и скорость резко падает: данные гоняются через шину PCIe.
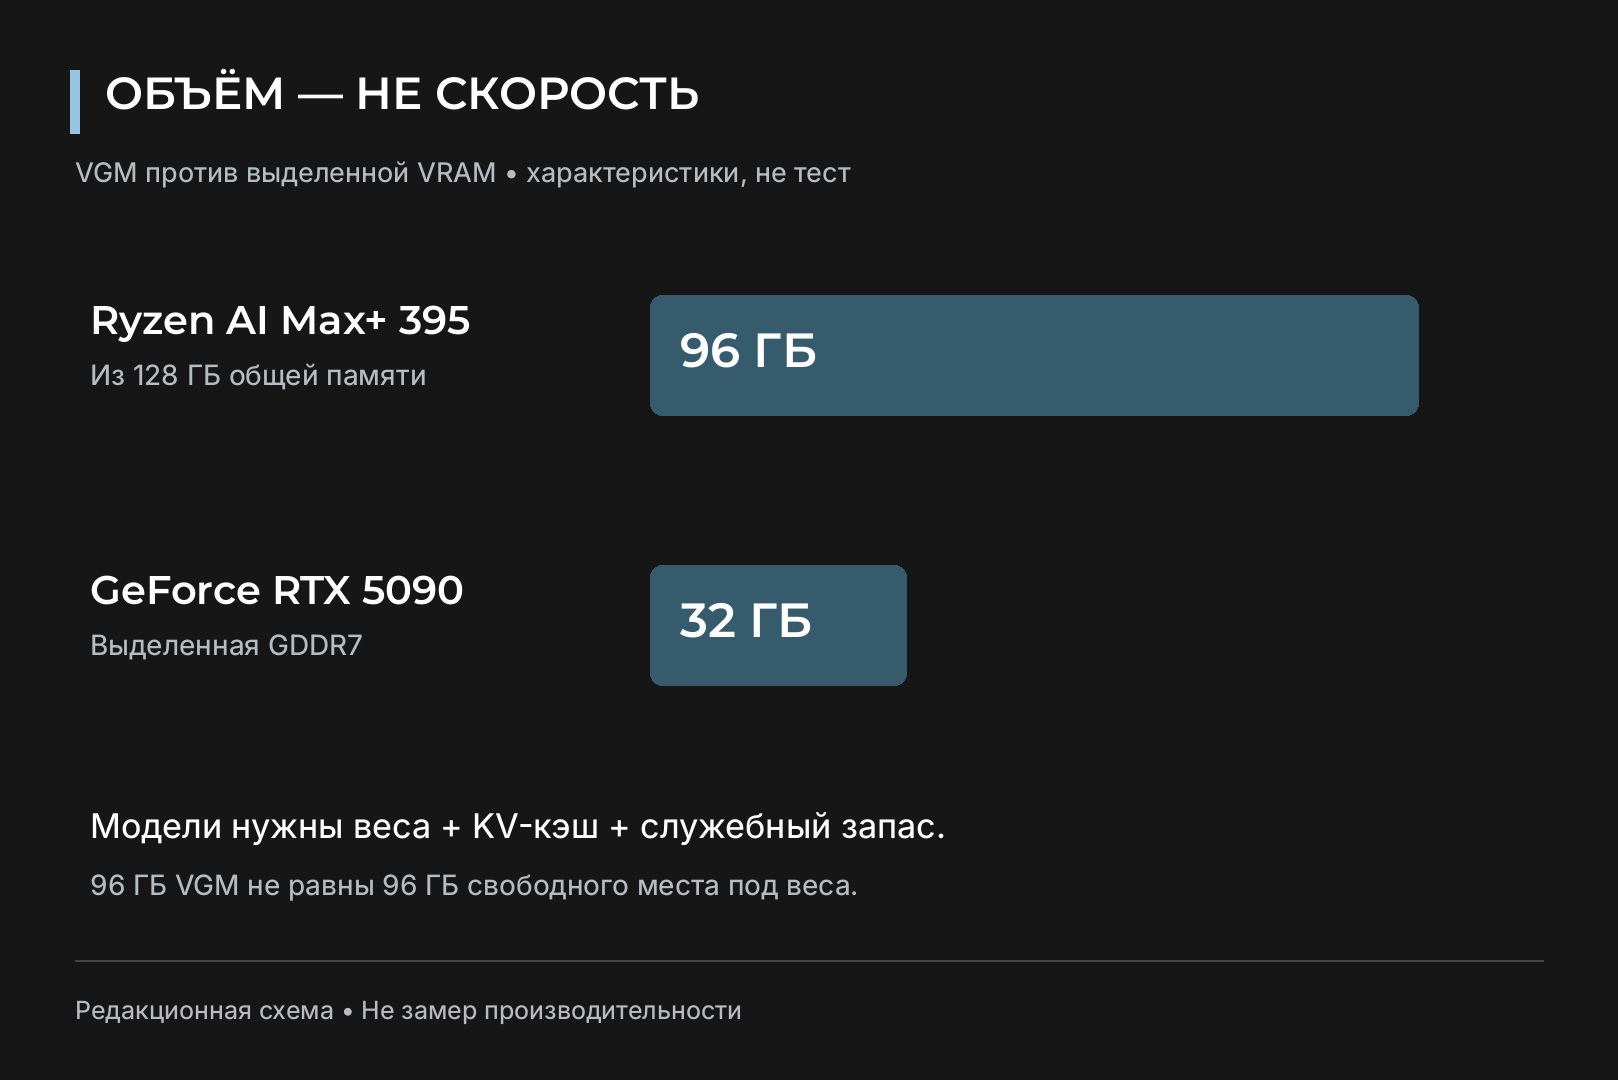
У Ryzen AI Max+ 395 физически один пул памяти на 256-битной шине. Процессор и графика обращаются к нему напрямую. Сколько из этого пула достанется графике, задаёт пользователь: в AMD это называется Variable Graphics Memory, настройка доступна в BIOS и в AMD Software Adrenalin Edition. На системе со 128 ГБ графике можно выделить до 96 ГБ.
Для сравнения: у GeForce RTX 5090 32 ГБ видеопамяти. То есть по объёму, доступному нейросети, APU в три раза выигрывает у самой мощной игровой видеокарты NVIDIA текущего поколения.
Характеристики Ryzen AI Max+ 395
| Параметр | Значение |
|---|---|
| Ядра и потоки | 16 ядер Zen 5, 32 потока |
| Частота | 3,0 до 5,1 ГГц |
| Кэш | 16 МБ L2, 64 МБ L3 |
| Встроенная графика | Radeon 8060S, 40 вычислительных блоков RDNA 3.5, до 2900 МГц |
| NPU | XDNA 2, 50 TOPS |
| Суммарная ИИ-производительность | до 126 TOPS (CPU, GPU и NPU вместе) |
| Память | до 128 ГБ LPDDR5X-8000, шина 256 бит |
| Техпроцесс | 4 нм |
| Анонс | январь 2025 года |
Цифру 126 TOPS не стоит путать с производительностью NPU: это сумма по всем вычислительным блокам. Для языковых моделей на практике работает графика, а не NPU.
Сколько памяти нужно модели
Грубая оценка простая: число параметров умножить на размер одного параметра. В 16 битах это 2 байта на параметр, в 8 битах 1 байт, в 4 битах около половины байта. Сверху нужен запас под контекст (KV-кэш) и служебные данные.
| Модель | Тип | Формат | Объём весов |
|---|---|---|---|
| gpt-oss-120b | MoE | MXFP4 | около 61 ГБ |
| Llama 4 Scout (109B, 17B активных) | MoE | 4 бита | помещается в 96 ГБ |
| Llama 3.3 70B | плотная | Q4_K_M | около 40 ГБ |
| Qwen3-30B-A3B | MoE, 3B активных | 4 бита | около 15 ГБ по формуле выше, плюс запас под контекст |
AMD указывает, что с драйвером Adrenalin 25.8.1 и новее в 96 ГБ помещаются модели до 128 миллиардов параметров в 4 битах. В 16 битах предел около 32B. Подробнее о расчёте объёма под конкретные модели мы писали в статье «Сколько VRAM нужно, чтобы запустить Llama 70B и DeepSeek локально».
Почему объём ещё не скорость
Когда языковая модель генерирует ответ, на каждый новый токен она читает из памяти все активные веса. Поэтому скорость генерации упирается в пропускную способность памяти, а не только в вычислительную мощность.
Здесь у APU главный компромисс. Теоретическая пропускная способность LPDDR5X-8000 на 256-битной шине около 256 ГБ/с, под реальной нагрузкой по замерам Codersera около 215 ГБ/с. У RTX 5090 около 1792 ГБ/с, то есть примерно в 8 раз больше.
Как это выглядит в цифрах по тем же замерам (Vulkan, 4-битные модели):
| Модель | Скорость генерации на Ryzen AI Max+ 395 |
|---|---|
| Qwen3-30B-A3B (MoE) | около 100 токенов/с |
| gpt-oss-120b (MoE) | около 55 токенов/с |
| Llama 3.3 70B (плотная) | около 4-6 токенов/с |
Разница между MoE и плотными моделями объясняется архитектурой. В MoE на каждый токен работает лишь часть экспертов: у Qwen3-30B-A3B это около 3 миллиардов параметров из 30. Читать из памяти приходится меньше, и медленная память не так мешает. Плотная модель 70B читает все веса на каждом токене, и скорость падает до уровня, при котором диалог становится неудобным.
На небольших моделях дискретная карта уходит далеко вперёд: на модели 8B Codersera получила около 186 токенов/с на RTX 5090 против 80-90 токенов/с на Strix Halo.
Есть и второй нюанс: обработка длинного промпта (prefill) нагружает вычислительные блоки, а 40 блоков встроенной графики заметно уступают крупным дискретным GPU. Если вы загружаете в модель длинные документы, разница будет ощутимой.
Программы и драйверы
Для запуска моделей на Ryzen AI Max+ 395 чаще всего используют LM Studio и llama.cpp с бэкендом Vulkan. AMD рекомендует драйвер Adrenalin 25.8.1 или новее: именно в нём появилась поддержка моделей до 128B на Windows. AMD также заявляет контекст до 256 тысяч токенов при включённых Flash Attention и Q8 KV-кэше.
Поддержка ROCm для этого чипа развивается, но пока уступает по зрелости. По наблюдениям Codersera, Vulkan сейчас разумный выбор по умолчанию, а ROCm выигрывает на очень длинных контекстах. На Linux объём памяти, доступной графике, настраивается параметрами ядра и может быть больше, чем на Windows.
Для обучения и дообучения моделей стандартом остаются видеокарты NVIDIA: экосистема CUDA, библиотеки и готовые инструкции заточены именно под них.
А что с играми
Radeon 8060S с 40 вычислительными блоками заметно сильнее привычной встроенной графики, но до дискретных игровых карт ей далеко. В тесте PCWorld Cyberpunk 2077 в Full HD с трассировкой лучей на ультра и FSR 2.1 в автоматическом режиме выдал в среднем 48,85 FPS, а в разрешении 3440 x 1440 уже 28,8 FPS. Для игр в высоком разрешении с трассировкой нужна дискретная видеокарта.
Ограничения платформы
- Память распаяна. LPDDR5X припаяна к плате, добавить объём позже нельзя. Выбирать конфигурацию нужно сразу с запасом, для крупных моделей это 128 ГБ.
- Нет пути апгрейда графики. Встроенную графику не заменить. Внешнюю видеокарту можно подключить только через USB4 или OCuLink, если он есть в конкретной модели, и это всегда компромисс по пропускной способности.
- Скорость плотных моделей. 70B в плотной архитектуре запустится, но работать с ней в режиме диалога будет медленно.
- Охлаждение зависит от производителя. Чип может потреблять до 120 Вт в зависимости от системы, поэтому реальная производительность сильно зависит от корпуса и системы охлаждения конкретного ПК.
Как выбрать: APU или ПК с видеокартой
Ответьте на три вопроса.
- Какие модели вы запускаете? Если основная работа идёт с моделями до 30B, ПК с одной мощной видеокартой даст ответы в разы быстрее. Если нужны MoE-модели на 100B и больше целиком в памяти одного устройства, у APU со 128 ГБ здесь реальное преимущество.
- Нужна ли скорость диалога? Для агентов, кодинга и чата важны десятки токенов в секунду. Ночная пакетная обработка документов терпит и медленную генерацию.
- Будете ли вы обучать модели и играть? Дообучение, генерация изображений и видео, игры в 4K лучше идут на дискретных видеокартах NVIDIA.
Если по итогам вы склоняетесь к системе с видеокартой, подобрать конфигурацию под конкретные модели можно в конфигураторе HYPERPC, а про выбор GPU под нейросети подробно рассказывает наш материал «Выбор видеокарты для машинного обучения и нейросетей».
Итог
Ryzen AI Max+ 395 решает задачу, с которой не справляется ни одна игровая видеокарта: держит в памяти графики модель на 60-90 ГБ без раскладки по нескольким устройствам. Лучше всего ему подходят MoE-модели, где читается лишь часть весов. Там, где важна скорость, большой контекст, обучение или игры, ПК с дискретной видеокартой остаётся более сильным выбором.
Рекомендуем