Мы готовы помочь Вам
Конвертация голоса RVC на домашнем компьютере: пошаговое руководство
RVC (Retrieval-based Voice Conversion) это проект с открытым кодом под лицензией MIT, который меняет тембр голоса на готовой аудиозаписи с помощью модели, обученной на записях нужного голоса. Всё работает локально: обучение и преобразование идут на вашей видеокарте, записи никуда не отправляются. Ниже по шагам: железо, установка, подготовка датасета, обучение, преобразование и типичные ошибки.
Что умеет RVC и чего не умеет
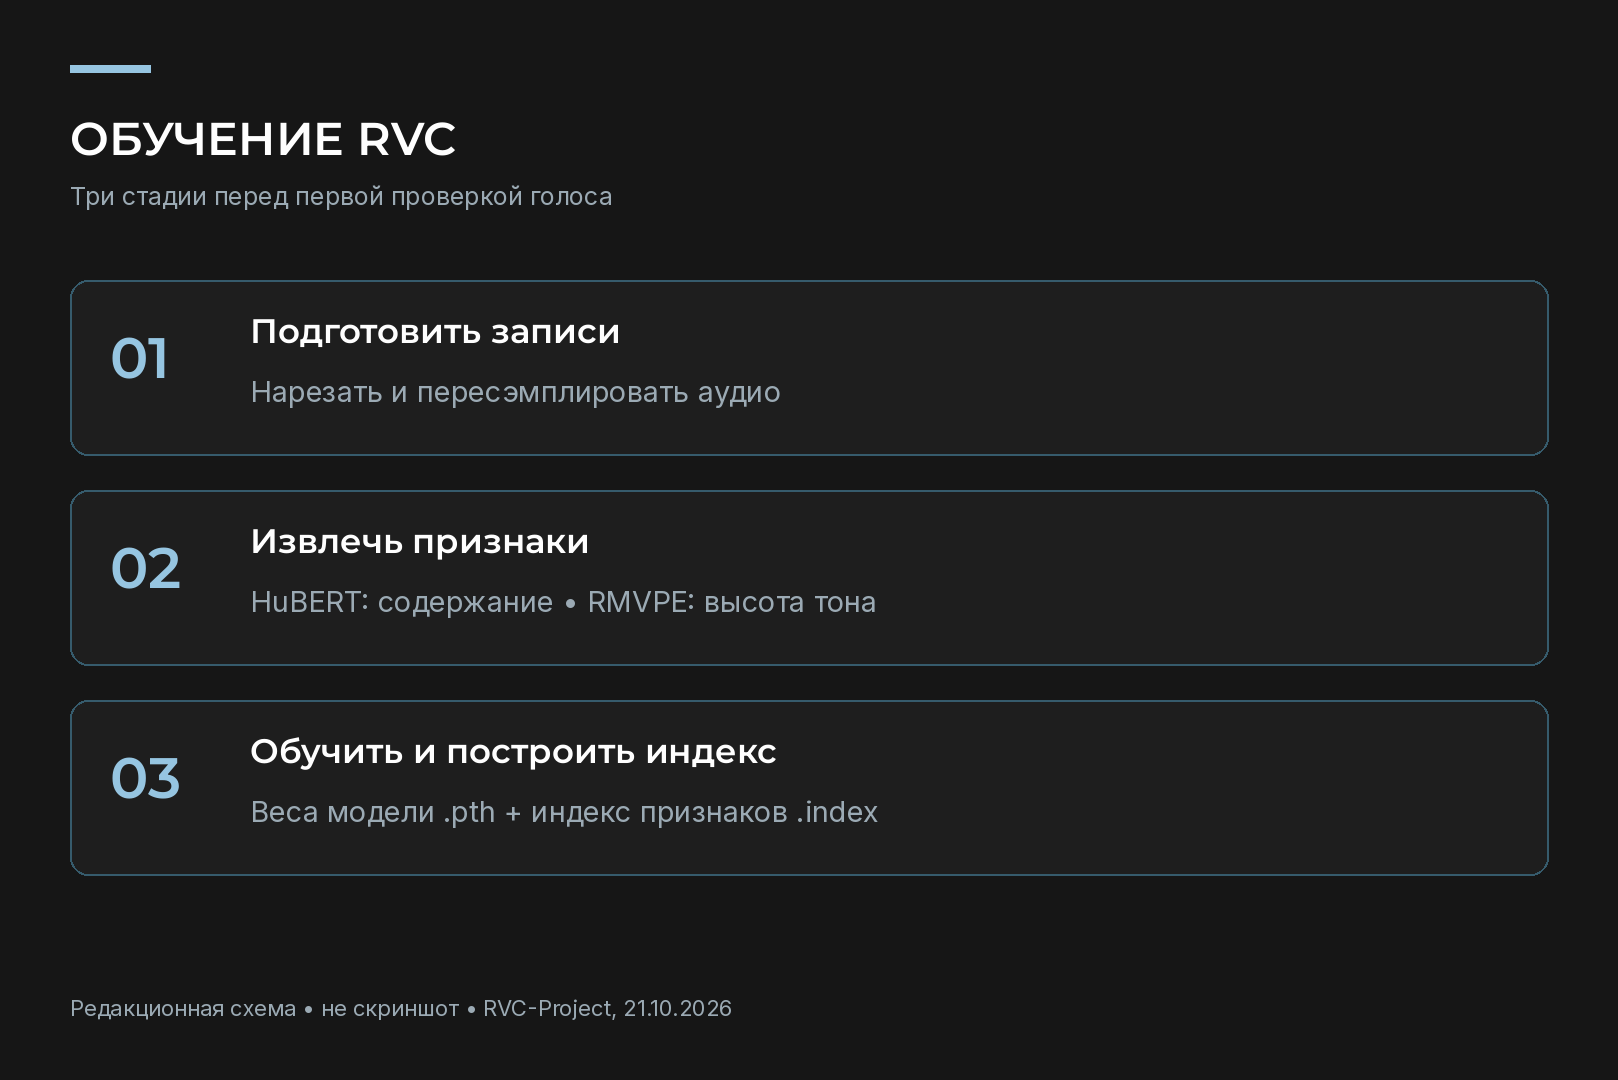
RVC берёт уже произнесённую фразу и переозвучивает её другим тембром. Содержание речи, интонация и темп остаются от исходной записи. Программа не читает текст сама и не переводит сказанное: для озвучки написанного текста сначала нужен синтезатор речи (TTS) или живая запись, а RVC применяется вторым шагом.
Слово retrieval в названии означает поиск внутри обучающих данных. При обработке система подменяет признаки исходного голоса ближайшими признаками из обучающего набора (поиск top-1), и так уменьшает «протекание» исходного тембра в результат. Интернет при этом не используется: поиск идёт по индексному файлу, который строится после обучения.
По данным разработчиков, в проекте есть:
- веб-интерфейс для обучения и преобразования;
- отдельный графический интерфейс для смены голоса в реальном времени;
- извлечение высоты тона алгоритмом RMVPE, который, по оценке авторов, даёт результат лучше Crepe_full, работает быстрее и требует меньше ресурсов;
- инструменты отделения голоса от музыки;
- слияние моделей.
Базовая модель предобучена примерно на 50 часах записей открытого набора VCTK, поэтому для своей модели хватает сравнительно небольшого датасета.
Шаг 1. Проверить железо
Требования зависят от задачи. Преобразование готовой моделью нагружает систему заметно меньше, чем обучение своей.
| Задача | Что важнее всего | Что говорит документация проекта |
|---|---|---|
| Обучение модели | объём видеопамяти | при нехватке памяти уменьшить batch size; если не помогает даже значение 1, нужна другая видеокарта |
| Преобразование записей | видеопамять и настройки фрагментов | для карт около 4 ГБ есть шанс работы после правки параметров x_pad, x_query, x_center, x_max в config.py |
| Подготовка датасета | оперативная память и ядра CPU | при ошибках памяти снизить число потоков CPU или заранее нарезать длинные записи |
| Реальное время | задержка звукового тракта | около 170 мс от входа до выхода, около 90 мс с ASIO-устройствами |
Batch size это число фрагментов, которые обрабатываются за один шаг обучения. Чем он больше, тем стабильнее и быстрее идёт обучение, но тем больше видеопамяти нужно. Поэтому видеокарта с большим объёмом памяти прежде всего сокращает время обучения, а не меняет качество голоса.
Перед покупкой комплектующих имеет смысл проверить текущий ПК на маленьком наборе: нарезать 10 минут записи, запустить короткое обучение и обработать одну фразу. Так станет видно, где именно упирается система: в видеопамять, в оперативную память или в процессор. Если компьютер нужен не только для RVC, но и для языковых моделей или генерации изображений, требования к видеокарте там другие, их мы разбирали в статье о выборе видеокарты для нейросетей.
Шаг 2. Выбрать набор зависимостей под видеокарту
Актуальная версия проекта рассчитана на Python 3.12 x64, для Linux рекомендуют Ubuntu 24.04. Набор пакетов зависит от видеокарты:
| Оборудование | Что ставить |
|---|---|
| NVIDIA GeForce RTX 50 | PyTorch 2.7.1 в варианте для CUDA 12.8, затем файл requirments_cu128_py312.txt |
| NVIDIA до RTX 50 | PyTorch 2.7.1 с CUDA 11.8, затем requirments_cu118_py312.txt |
| AMD, Intel или только процессор | файл requirments_cpu_py312.txt; на Windows ускорение через DirectML, на Linux расчёт на CPU |
В названиях файлов опечатка «requirments» сделана авторами, так их и нужно вводить. Для видеокарт AMD и Intel на Windows дополнительно понадобится файл модели rmvpe.onnx.
Если ставить окружение вручную не хочется, есть Applio: проект на базе RVC с настольным приложением для Windows, macOS и Linux. В документации Applio указаны NVIDIA через CUDA, поддерживаемые конфигурации AMD и Apple через MPS. Скомпилированный пакет для Windows уже содержит своё окружение Python, его достаточно распаковать и запустить run-applio.bat.
Шаг 3. Установить RVC
- Скачать репозиторий RVC-Project/Retrieval-based-Voice-Conversion-WebUI с GitHub в папку без пробелов, скобок и кириллицы в пути.
- Создать виртуальное окружение Python 3.12 и обновить pip, setuptools и wheel.
- Для NVIDIA сначала поставить нужную пару PyTorch, затем файл зависимостей из таблицы выше.
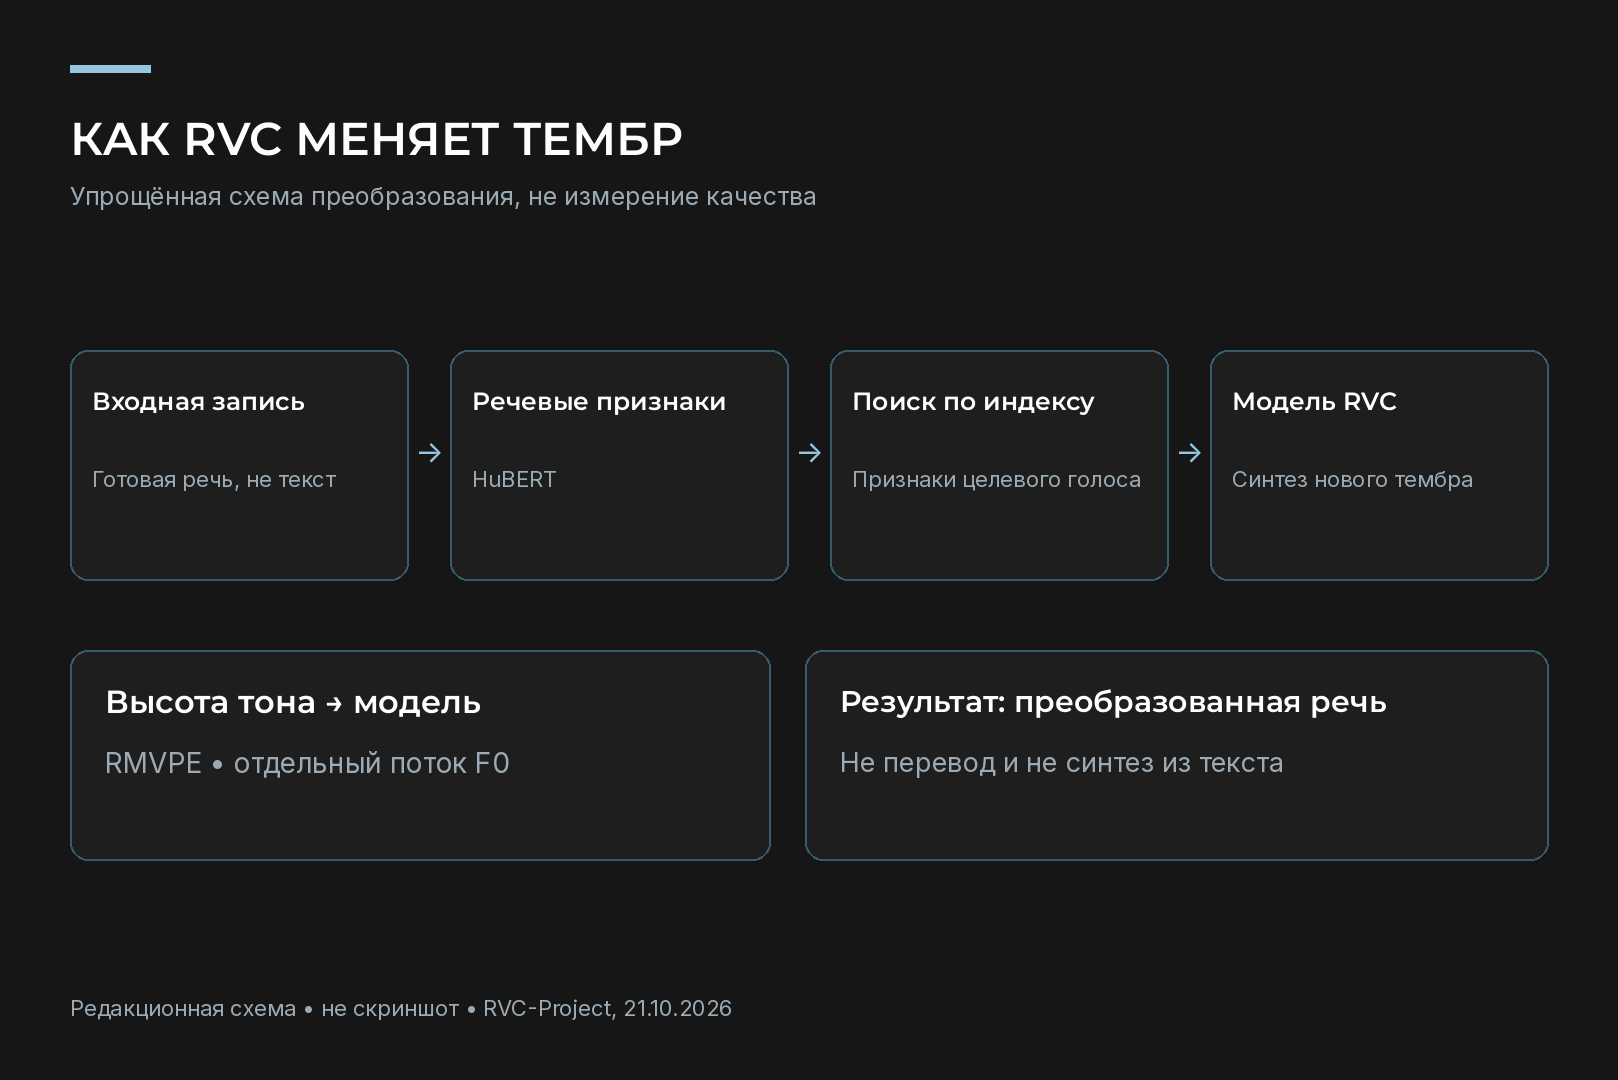
- На Windows положить
ffmpeg.exeиffprobe.exeв корень папки проекта. На Ubuntu поставить пакеты ffmpeg, libsndfile1 и libportaudio2. - Скачать предобученные модели из репозитория lj1995/VoiceConversionWebUI на Hugging Face:
hubert_baseиrmvpe.ptнужны для преобразования, каталогиpretrainedиpretrained_v2и архивmute.zip(распаковывается вlogs/mute) нужны для обучения. - Запустить веб-интерфейс командой
python webui.pyили файломgo-webui.bat. Он откроется в браузере на порту 7865. Интерфейс для работы в реальном времени запускается черезgo-realtime_gui.bat.
Шаг 4. Подготовить записи
Качество модели почти целиком определяется датасетом. Рекомендации из FAQ проекта:
- оптимальный объём от 10 до 50 минут чистой речи;
- для очень характерного голоса в хорошем качестве может хватить 5-10 минут;
- меньше минуты записи не рекомендуется;
- если звук чистый и тембр однородный, датасет можно увеличить.
Практические правила подготовки:
- Записывать в тихой комнате одним микрофоном, без музыки, эха и шумоподавления «на лету».
- Если есть фоновая музыка, сначала отделить голос встроенным инструментом разделения.
- Убрать длинные паузы, кашель, щелчки и чужие голоса.
- Сложить файлы в одну папку без вложенных каталогов: по старой инструкции проекта файлы из подпапок не загружаются.
- Проверить путь: пробелы, скобки и нелатинские символы в пути к записям вызывают ошибки FFmpeg и кодировки UTF-8.
Длинные записи программа сама режет по паузам и затем на фрагменты около 4 секунд с перекрытием 0,3 секунды. Если на этом этапе не хватает оперативной памяти, помогает заранее разрезать файлы на куски по несколько минут.
Шаг 5. Обучить модель
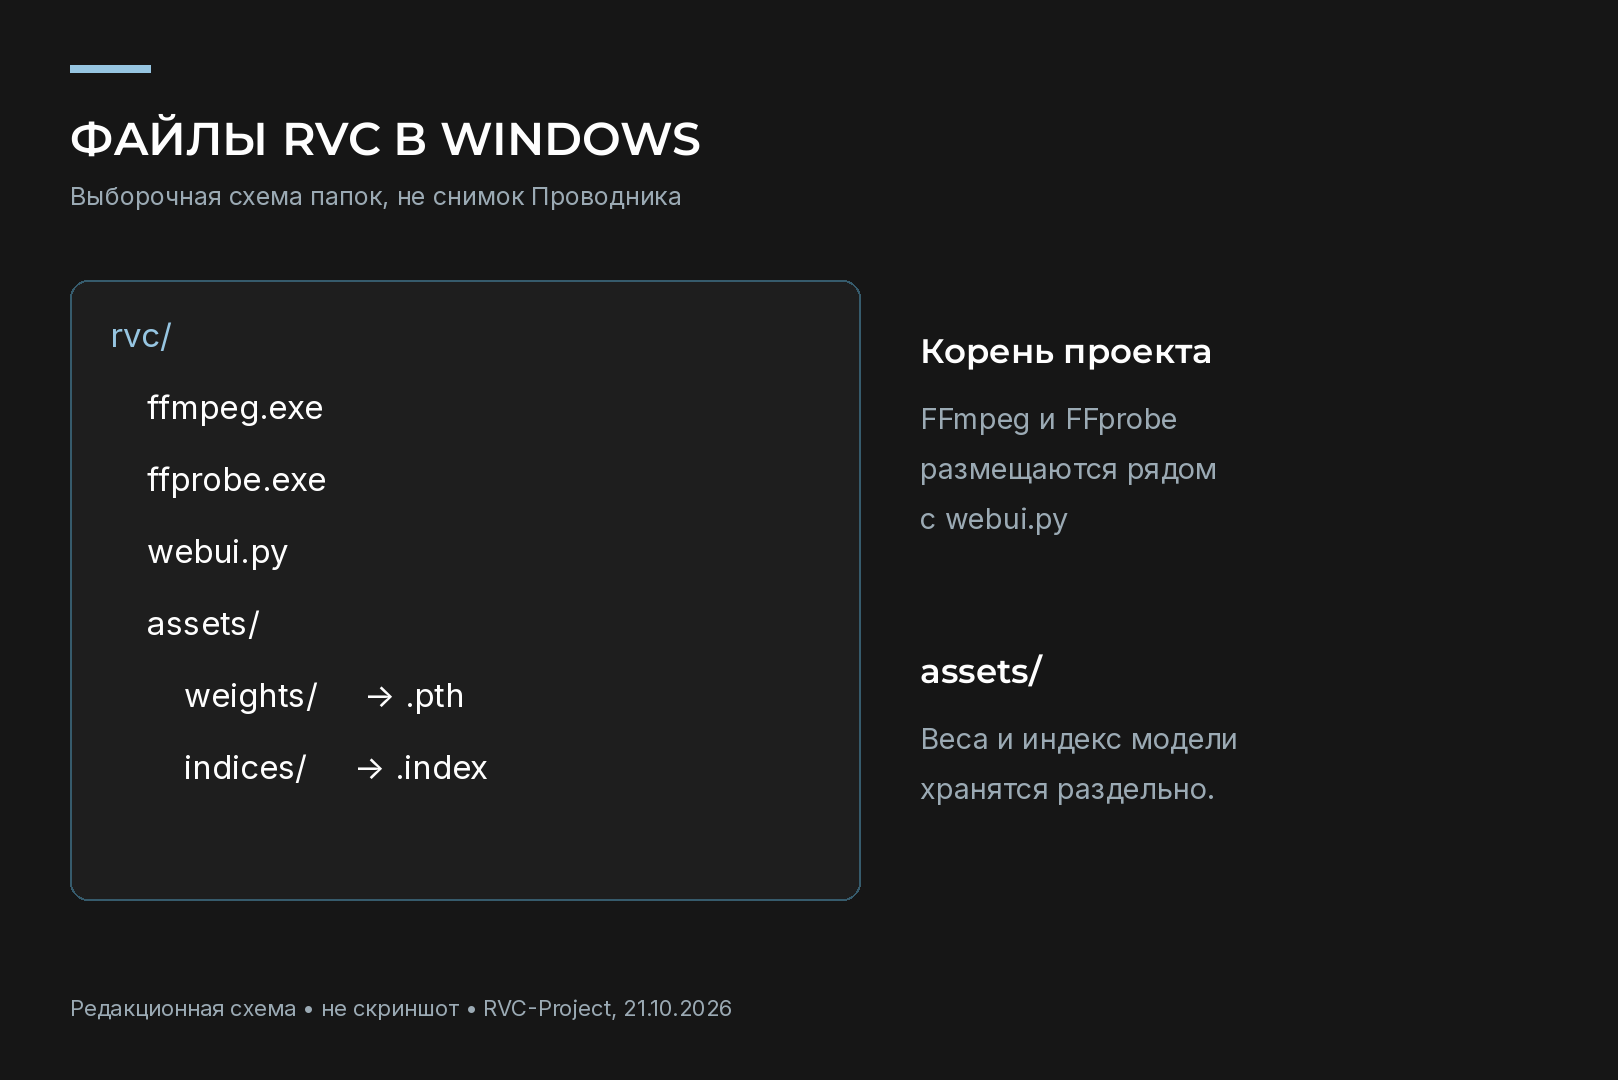
Обучение в веб-интерфейсе идёт в три этапа:
- Обработка данных. Задать имя эксперимента и указать, нужна ли модели высота тона (для пения нужна обязательно). Записи нарезаются и пересэмплируются.
- Извлечение признаков. Программа вычисляет высоту тона и речевые признаки HuBERT. Для высоты тона имеет смысл выбрать RMVPE.
- Обучение и индекс. Запустить обучение модели от предобученных весов, затем построить индекс признаков (библиотека faiss, файл
added_XXX.index).
Сколько эпох ставить, зависит от качества записей:
| Датасет | Рекомендуемое число эпох по FAQ |
|---|---|
| шумные записи, плохое качество | 20-30, больше не улучшит результат |
| чистые записи достаточной длины | можно больше, 200 допустимо |
Batch size подбирать снизу вверх: начать с малого значения и увеличивать, пока обучение идёт без ошибки нехватки памяти. Загрузку видеопамяти на NVIDIA удобно смотреть командой nvidia-smi.
Шаг 6. Преобразовать запись
Готовая модель состоит из двух файлов: весов .pth (кладутся в assets/weights/) и индекса .index (в assets/indices/). Без индекса преобразование работает, но хуже держит тембр.
Главная ручка на вкладке преобразования это index rate:
- значение 1 максимально тянет звучание к тембру из обучающих записей;
- значение 0 отключает подмешивание признаков из индекса;
- если датасет длинный и чистый, роль индекса снижается и его можно не использовать.
Для первой проверки лучше записать новую фразу своим голосом, которой не было в датасете. Так сразу слышно, научилась ли модель переносить тембр, а не просто запомнила обучающие фрагменты.
Частые ошибки и что с ними делать
| Симптом | Причина | Решение |
|---|---|---|
| CUDA out of memory при обучении | слишком большой batch size | уменьшить batch size; если не помогает даже 1, видеопамяти недостаточно |
| Нехватка видеопамяти при преобразовании | крупные фрагменты обработки | уменьшить x_pad, x_query, x_center, x_max в config.py |
| Ошибка оперативной памяти на подготовке | много параллельных процессов | снизить число потоков CPU, нарезать длинные записи |
| Ошибка FFmpeg или UTF-8 | путь с пробелами, скобками, нелатинскими символами | перенести проект и записи в простой латинский путь |
| В результате слышен исходный голос | слабый индекс или низкий index rate | поднять index rate, проверить, что индекс построен |
Чей голос можно обучать: согласие и закон
Для первых опытов лучше всего подходит собственный голос: так проверяется и техника, и качество без вопросов о правах. С чужим голосом всё сложнее.
- Персональные данные. Запись голоса может относиться к персональным данным, если по ней можно определить человека (статья 3 закона № 152-ФЗ). Для обработки нужно основание из статьи 6, одно из них согласие. Если обработка опирается на согласие, статья 9 требует оформить его отдельным документом.
- Биометрия. Не любая запись голоса автоматически становится биометрическими данными: статья 11 закона № 152-ФЗ связывает этот режим с использованием характеристик для установления личности.
- Права исполнителя. Запись актёрского или музыкального исполнения охраняется статьёй 1317 ГК РФ. То, что файл лежит в открытом доступе, не даёт права обучать на нём модель.
В договоре с владельцем голоса стоит прописать, какие записи используются для обучения, где будут звучать результаты, кто получает доступ к модели и когда файлы удаляются. При публикации честно указывать, что голос преобразован нейросетью, и не выдавать созданные реплики за реальные слова человека.
Итог
RVC запускается на обычном домашнем ПК: для преобразования хватает средней видеокарты, а объём видеопамяти определяет главным образом скорость обучения и допустимый batch size. Больше всего на результат влияет не железо, а датасет: 10-50 минут чистой речи одного человека дают предсказуемую модель. Если же нужна машина под несколько нейросетевых задач сразу, конфигурацию с запасом по видеопамяти и ОЗУ можно подобрать в конфигураторе HYPERPC.
Рекомендуем