Мы готовы помочь Вам
Stable Diffusion на своём ПК: какая видеокарта и сколько VRAM нужно в 2026 году
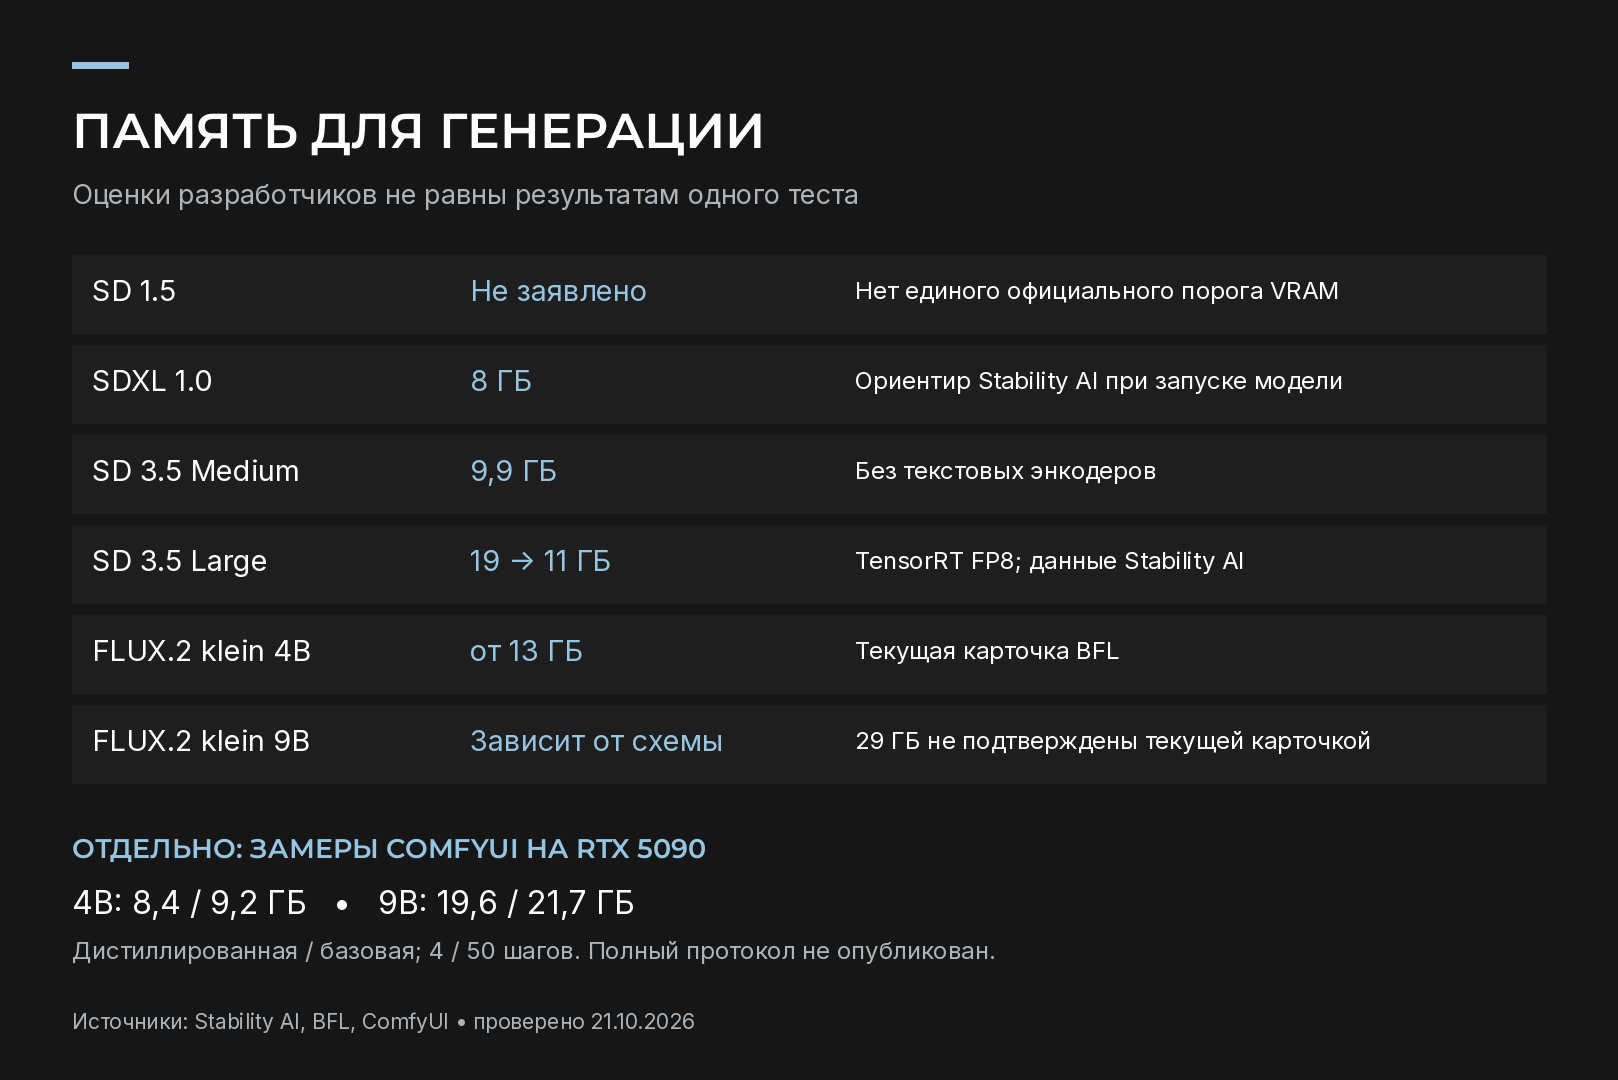
Короткий ответ: для SD 1.5 и SDXL хватает 8 ГБ видеопамяти, для SD 3.5 Medium и FLUX.2 [klein] 4B стоит рассчитывать на 12-16 ГБ, а SD 3.5 Large и FLUX.2 [klein] 9B без сжатия весов просят 18-29 ГБ. Ниже таблица с цифрами разработчиков, разбор того, что на самом деле занимает память, и подбор видеокарты под конкретную задачу.
Сводная таблица: сколько VRAM просят модели
В таблице собраны цифры из карточек моделей и официальных анонсов. Это ориентиры при генерации одного изображения стандартного размера, а не гарантированный минимум для любой схемы: дополнительные модули и большие разрешения поднимают расход.
| Модель | Размер основной модели | Родное разрешение | Ориентир по VRAM от разработчика | Что учесть |
|---|---|---|---|---|
| Stable Diffusion 1.5 | 0,9 млрд параметров | 512 × 512 | отдельной цифры нет | самая лёгкая, работает на 8 ГБ с запасом |
| SDXL 1.0 | 3,5 млрд (вся связка 6,6 млрд) | 1024 × 1024 | 8 ГБ | на 8 ГБ запускается, но с выгрузкой медленнее |
| SD 3.5 Medium | 2,5 млрд | 0,25-2 Мп | 9,9 ГБ без текстовых энкодеров | энкодеры CLIP и T5 добавляют расход сверху |
| SD 3.5 Large | 8,1 млрд | 1 Мп | более 18 ГБ | в FP8 через TensorRT около 11 ГБ на RTX 40 и новее |
| FLUX.2 [klein] 4B | 4 млрд | в карточке не указано | около 13 ГБ | в тесте ComfyUI на RTX 5090 от 8,4 до 9,2 ГБ |
| FLUX.2 [klein] 9B | 9 млрд + энкодер Qwen3 8B | в карточке не указано | около 29 ГБ | в тесте ComfyUI от 19,6 до 21,7 ГБ |
Почему у FLUX.2 [klein] две разные цифры? Карточка модели на Hugging Face описывает всю схему с текстовым энкодером в BF16, а блог ComfyUI приводит замеры в его собственном интерфейсе, где компоненты загружаются по очереди. Обе цифры честные, просто условия разные. Для планирования покупки разумнее опираться на большую.
Модели отличаются и лицензиями. SD 1.5 распространяется по CreativeML OpenRAIL-M, SD 3.5 по Stability AI Community License (коммерческое использование без отдельного договора, пока годовая выручка меньше 1 млн долларов), FLUX.2 [klein] 4B под Apache 2.0, а версия 9B только для некоммерческих задач.
Что на самом деле занимает видеопамять
Распространённая ошибка: смотреть на размер файла модели и считать, что это и есть требование к видеокарте. На деле в память попадает вся цепочка генерации плюс временные данные.
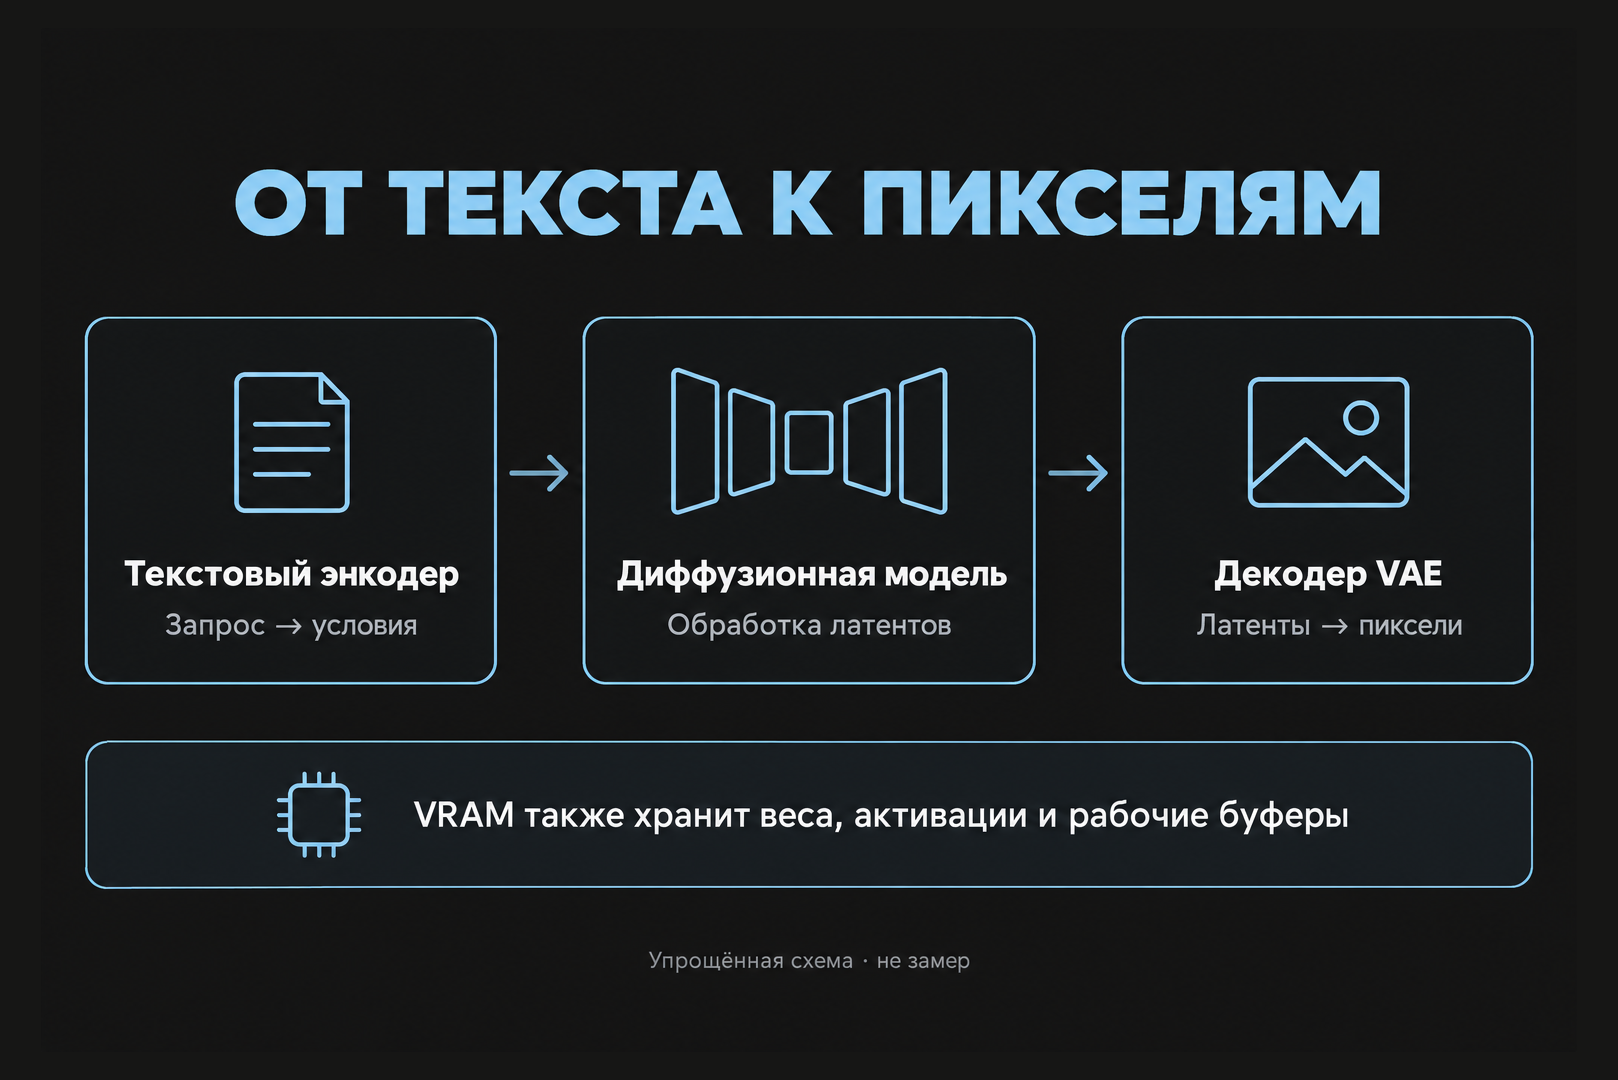
Компоненты схемы
Генерация идёт в три этапа. Текстовый энкодер превращает запрос в набор чисел, диффузионная модель шаг за шагом строит изображение в сжатом латентном пространстве, а VAE разворачивает результат в обычную картинку. У старых моделей энкодер компактный, у новых он сам по себе крупная нейросеть: в SD 3.5 это три энкодера (два CLIP и T5-XXL), а у FLUX.2 [klein] 9B текстовую часть обрабатывает Qwen3 на 8 млрд параметров. Именно поэтому заявленные Stability AI 9,9 ГБ для SD 3.5 Medium нельзя считать требованием ко всей схеме: в эту цифру энкодеры не входят.
Разрешение и число картинок за проход
Чем больше кадр, тем больше промежуточных данных на каждом шаге. Веса модели при этом не меняются, поэтому расход растёт не строго пропорционально числу пикселей, но переход с 1024 × 1024 на 2048 × 2048 может упереться в лимит памяти там, где базовый размер работал спокойно.
То же касается батча, то есть числа изображений, которые считаются одновременно. Десять картинок одним батчем требуют заметно больше памяти, чем десять запусков подряд по одной. При нехватке VRAM первое, что стоит сделать, это вернуть батч к единице и поставить генерации в очередь.
Формат весов
Одно и то же число параметров может занимать разный объём. FP16 и BF16 хранят каждое число в 16 битах, FP8 в 8 битах, а 4-битные варианты ещё компактнее. NVIDIA и Stability AI показали, что перевод SD 3.5 Large в FP8 через TensorRT снижает расход памяти на 40% (с более чем 18 до 11 ГБ) и ускоряет генерацию в 2,3 раза по сравнению с BF16 в PyTorch. Ограничение важное: аппаратную поддержку FP8 имеют видеокарты RTX 40 и более новые, а на RTX 50 добавлен ещё и FP4.
Квантование экономит память ценой возможной потери деталей. Лица, мелкий текст на изображении и тонкие текстуры лучше сравнивать на своих запросах, прежде чем окончательно переходить на сжатую версию.
Дополнения к схеме
ControlNet (управление позой, контурами, глубиной), IP-Adapter (референс по картинке), refiner и апскейл добавляют собственные модели. Универсальной надбавки нет: всё зависит от модуля и того, держит ли программа их в памяти одновременно или подгружает по очереди. Готовая LoRA весит немного, а вот обучение своей LoRA это отдельная задача с более высокими требованиями, и её стоит проверять по документации конкретного тренера.
Как проверить, хватает ли вашей видеокарты
Прежде чем менять железо, стоит замерить реальный расход на своей схеме. Это занимает пять минут.
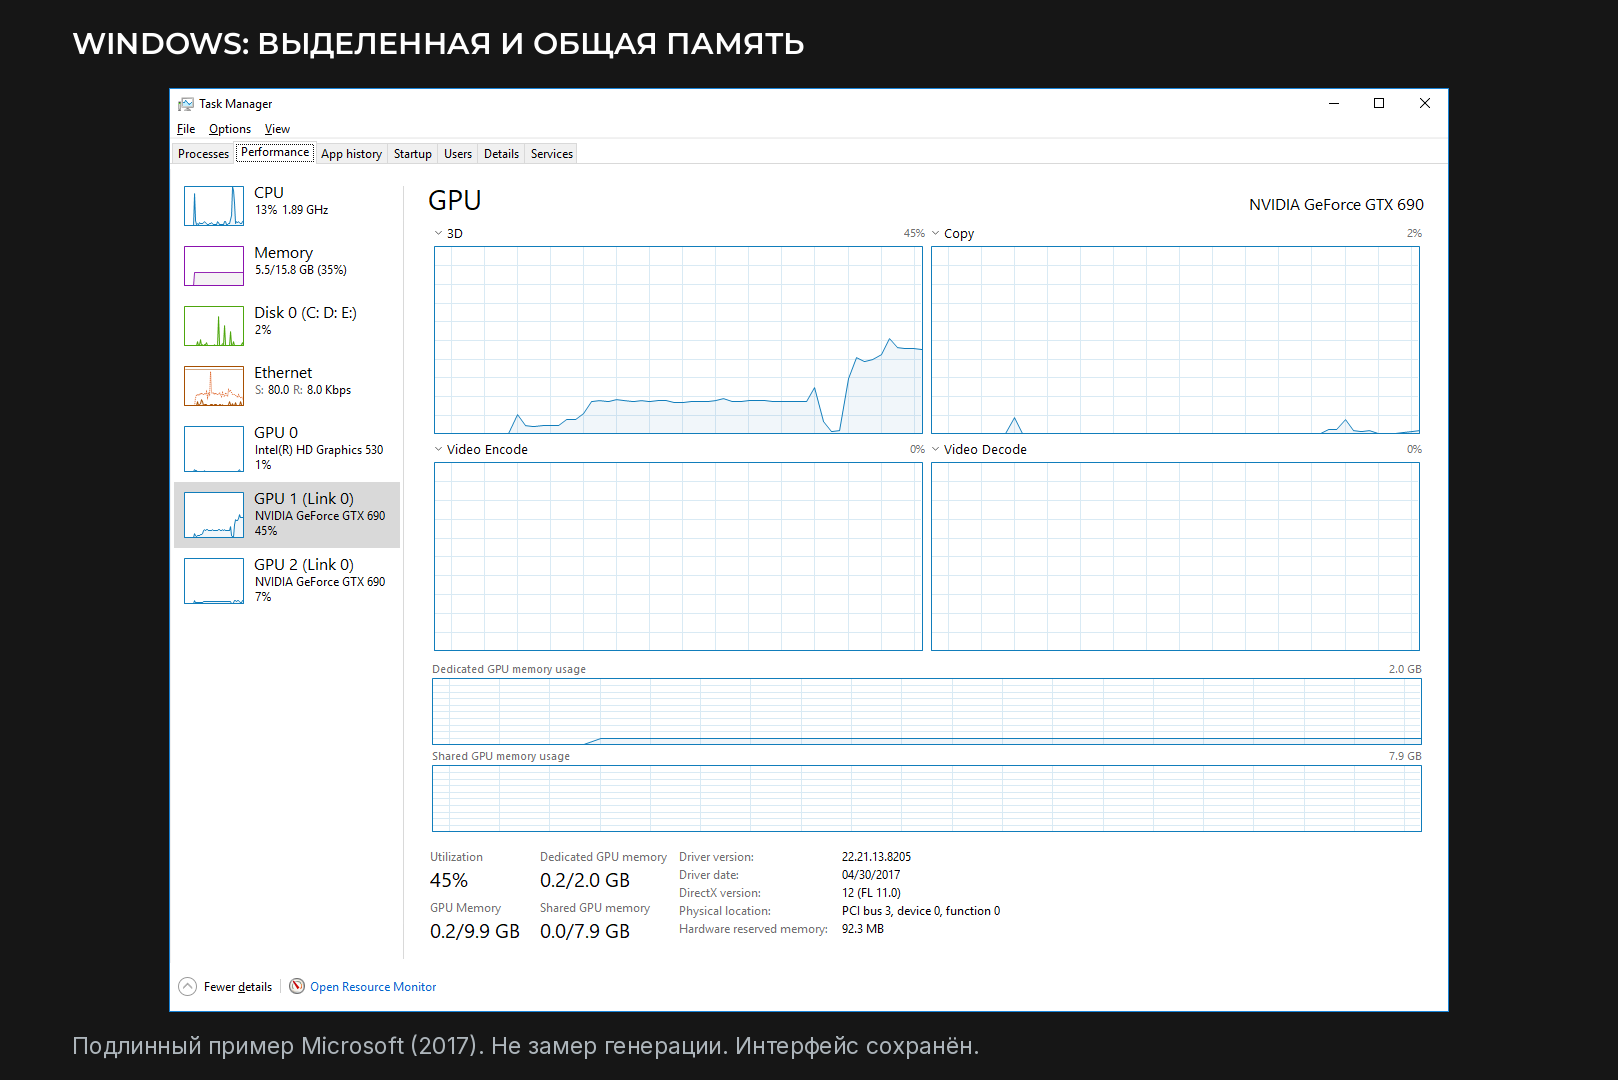
- Узнайте объём памяти карты. В Windows откройте Диспетчер задач, вкладку «Производительность», раздел «Графический процессор»: строка «Выделенная память графического процессора» показывает объём VRAM. Владельцам NVIDIA то же покажет команда nvidia-smi в терминале.
- Запустите одну генерацию с батчем 1 в базовом разрешении модели. Первый запуск не показателен, потому что веса только загружаются с диска.
- Во время второго запуска следите за пиком выделенной памяти. Если она упирается в потолок, а рядом растёт «Общая память графического процессора», программа выгружает данные в оперативную память. Картинка получится, но заметно медленнее.
- Меняйте по одному параметру: разрешение, батч, формат весов, дополнительные модули. Так видно, что именно съедает запас.
Для самого запуска удобнее всего ComfyUI. Разработчики заявляют поддержку видеокарт NVIDIA, AMD (архитектуры RDNA 2, RDNA 3, RDNA 3.5 и RDNA 4 через ROCm), Intel Arc и Apple Silicon, а умное распределение памяти между VRAM и RAM позволяет запускать даже крупные модели на 4 ГБ видеопамяти и 8 ГБ оперативной, пусть и медленно. В списке поддерживаемых моделей есть SD 1.5, SDXL, SD 3.5, FLUX.1 и FLUX.2.
Какую видеокарту выбрать под свою задачу
Объём памяти для генерации изображений важнее, чем для игр: нехватка VRAM в играх снижает FPS, а здесь она либо замедляет работу в разы из-за выгрузки, либо не даёт запустить модель вовсе. Ниже актуальные карты NVIDIA по данным официальной таблицы характеристик.
| Видеокарта | Объём и тип памяти | Что на ней комфортно |
|---|---|---|
| GeForce RTX 5060 | 8 ГБ GDDR7 | SD 1.5, SDXL в базовом разрешении |
| GeForce RTX 5070 | 12 ГБ GDDR7 | SDXL с дополнениями, SD 3.5 Large в FP8 впритык |
| GeForce RTX 5060 Ti 16 ГБ | 16 ГБ GDDR7 | SD 3.5 Medium, FLUX.2 [klein] 4B |
| GeForce RTX 5070 Ti, RTX 5080 | 16 ГБ GDDR7 | то же, но быстрее; запас на ControlNet |
| GeForce RTX 5090 | 32 ГБ GDDR7 | SD 3.5 Large в BF16, FLUX.2 [klein] 9B |
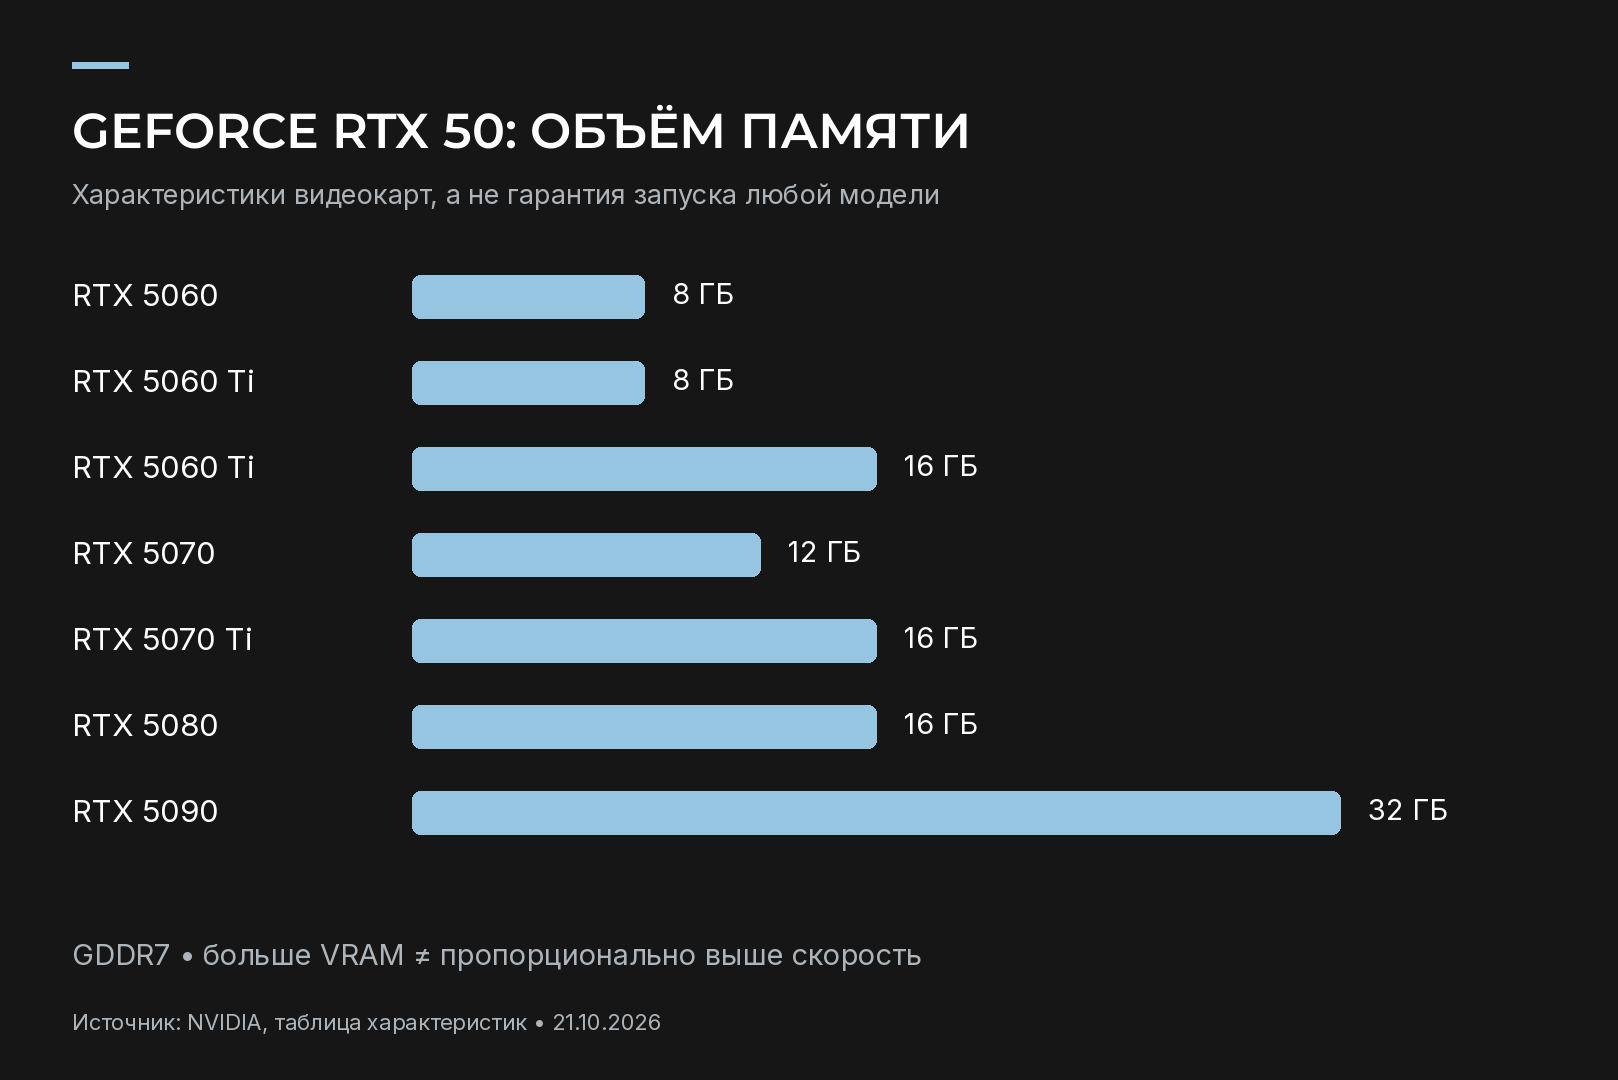
Как читать таблицу. Если вы только пробуете генерацию, 8-12 ГБ хватит для знакомства с SD 1.5 и SDXL. Если планируете регулярно работать с моделями 2025-2026 годов, ориентир это 16 ГБ: на них помещаются SD 3.5 Medium и FLUX.2 [klein] 4B. Для SD 3.5 Large без сжатия и FLUX.2 [klein] 9B нужен класс 24-32 ГБ: в карточке 9B разработчик прямо называет RTX 4090 и старше.
Про прошлые поколения. RTX 4090 и RTX 3090 с 24 ГБ GDDR6X относятся к предыдущим линейкам, но по объёму памяти остаются рабочим вариантом для тяжёлых моделей, если карта уже стоит в системе. Нюанс у RTX 3090: поддержку FP8 NVIDIA заявляет только для RTX 40 и новее, поэтому FP8-версия SD 3.5 Large через TensorRT на ней не даст той экономии памяти.
Когда памяти нужно больше 32 ГБ, например для обучения или нескольких одновременно работающих сервисов, стоит смотреть на профессиональные карты. Подробно о них в нашем материале про выбор видеокарты для машинного обучения и нейросетей.
Остальная система
Видеокарта главная, но не единственная. При нехватке VRAM программы выгружают компоненты в оперативную память, поэтому её объём должен с запасом вмещать модели, которые не поместились на GPU. Модели весят десятки гигабайт, и быстрый NVMe SSD сокращает время первой загрузки и переключения между ними. Процессор в генерации почти не участвует, если она идёт на видеокарте.
Если подбираете компьютер именно под локальную генерацию, в конфигураторе HYPERPC можно сразу задать нужный объём видеопамяти, оперативной памяти и накопителя под свои модели.
Итог
- 8 ГБ: SD 1.5 и SDXL, хорошо для старта.
- 12 ГБ: SDXL с дополнениями, SD 3.5 Large в FP8 на RTX 40 и новее.
- 16 ГБ: рабочий минимум для актуальных моделей, включая SD 3.5 Medium и FLUX.2 [klein] 4B.
- 24-32 ГБ: SD 3.5 Large без сжатия и FLUX.2 [klein] 9B.
Перед покупкой замерьте свою схему: реальный расход зависит от разрешения, батча, формата весов и дополнений сильнее, чем от названия модели.
Рекомендуем